Qwen3.8 27B lokal: Wie Bonsai 2 ein 55-GB-KI-Modell auf wenige Gigabyte schrumpft
Ternäre Kompression, Hardwarebedarf und Installation unter Windows, Linux und macOS
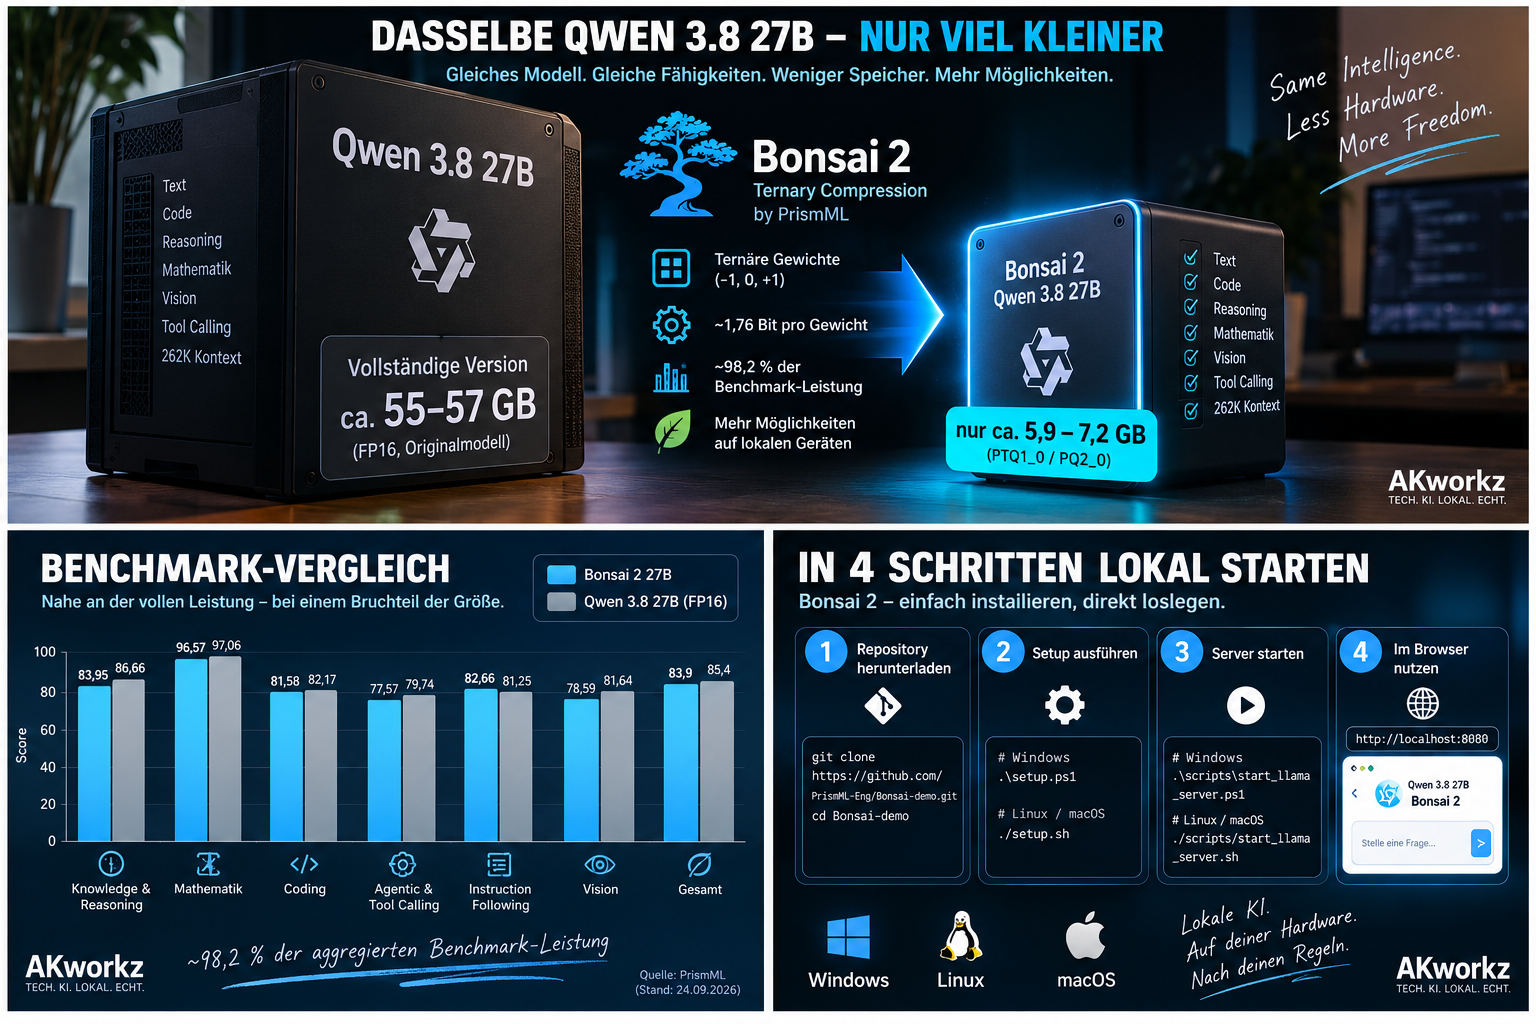
Ein leistungsfähiges 27-Milliarden-Parameter-KI-Modell lokal auf einem normalen PC oder Notebook betreiben? Was bei Qwen3.8 27B in voller Präzision noch rund 55 bis 57 GB Modelldaten bedeutet, reduziert PrismML mit Bonsai 2 auf ungefähr 5,9 bis 7,2 GB. Das Bemerkenswerte daran: Bonsai 2 ist kein kleineres 7B- oder 8B-Modell, sondern basiert direkt auf Qwen3.8 27B und soll laut Hersteller rund 98,2 Prozent der Benchmark-Leistung des Full-Precision-Modells erhalten.
Damit wird eine Klasse lokaler KI-Systeme interessant, für die bisher Workstations mit sehr viel Arbeitsspeicher, Unified Memory oder mehreren GPUs nötig waren.
Doch wie funktioniert das? Was verliert man tatsächlich? Und wie lässt sich Bonsai 2 auf Windows, Linux oder macOS installieren?
Stand dieses Artikels: 24. September 2026.
Was ist Qwen3.8 27B?
Qwen3.8 27B ist ein multimodales KI-Modell der Qwen-Familie mit rund 27 Milliarden Parametern.
Es kann nicht nur klassische Textaufgaben übernehmen, sondern unter anderem:
- Texte analysieren und erstellen
- Programmcode schreiben und verstehen
- komplexere Schlussfolgerungen durchführen
- mathematische Aufgaben bearbeiten
- Bilder und Screenshots analysieren
- mit Tools und Agentensystemen arbeiten
- längere Dokumente und große Kontexte verarbeiten
- als lokaler Coding- oder Recherche-Agent eingesetzt werden
Das offizielle Modell wird von Qwen auf Hugging Face als Image-Text-to-Text-Modell unter der Apache-2.0-Lizenz bereitgestellt. Das vollständige Repository umfasst derzeit etwa 55,6 GB.
Das ist für ein 27B-Modell zunächst nicht ungewöhnlich. Werden Milliarden Parameter mit 16 Bit gespeichert, entstehen sehr große Modelldateien.
Genau hier setzt Bonsai 2 an.
Was ist Bonsai 2 27B?
Ternary Bonsai 2 27B von PrismML basiert direkt auf Qwen3.8 27B.
Es handelt sich also nicht um ein unabhängiges kleines Modell, das versucht, Qwen nachzuahmen.
PrismML nimmt das große Qwen3.8-27B-Modell und überführt dessen Gewichte in eine extrem speichereffiziente ternäre Darstellung.
Statt jeden Gewichtswert als relativ hochpräzise Gleitkommazahl zu speichern, können die ternären Gewichte im Kern nur drei Zustände annehmen:
-1, 0 oder +1
Zusätzlich verwendet PrismML gruppenweise Skalierungsinformationen. Für Bonsai 2 gibt PrismML effektiv ungefähr 1,76 Bit pro Gewicht an.
Das Ergebnis ist erstaunlich:
| Modell | Modellgröße ungefähr |
|---|---|
| Qwen3.8 27B Full Precision | ca. 55–57 GB |
| Qwen3.8 27B typische 4-Bit-Quantisierung | ca. 17 GB |
| Bonsai 2 27B PTQ1_0 | ca. 5,9 GB |
| Bonsai 2 27B PQ2_0 | ca. 7,2 GB |
PrismML beschreibt Bonsai 2 damit als mehr als neunmal kleiner als die Full-Precision-Ausgangsversion.
Ist Bonsai 2 wirklich dasselbe Qwen3.8 27B?
Hier muss man genau unterscheiden.
Architektonisch und von seiner Abstammung her: ja.
Bonsai 2 basiert auf Qwen3.8 27B. Es besitzt weiterhin die 27B-Modellklasse und übernimmt die grundlegenden Fähigkeiten des Ausgangsmodells.
Numerisch ist es jedoch nicht exakt dasselbe Modell.
Durch die extreme Kompression werden die ursprünglichen hochpräzisen Gewichtswerte verändert.
„Bonsai 2 ist exakt genauso leistungsfähig wie das 55-GB-Qwen“ — diese Aussage wäre technisch nicht korrekt.
Die deutlich interessantere Aussage lautet:
PrismML misst bei einem Modell von nur rund 5,9 GB noch etwa 98,2 Prozent der aggregierten Benchmark-Leistung des vollständigen Qwen3.8 27B.
Und das ist ein erheblicher Unterschied zu vielen klassischen extremen Quantisierungen.
Bonsai 2 gegen Qwen3.8 27B: Wie groß ist der Qualitätsverlust?
PrismML hat beide Modelle auf einer Benchmark-Suite mit Aufgaben aus mehreren Kategorien getestet. Die veröffentlichten Ergebnisse:
| Bereich | Bonsai 2 27B | Qwen3.8 27B |
|---|---|---|
| Knowledge & Reasoning | 83,95 | 86,66 |
| Mathematik | 96,57 | 97,06 |
| Coding | 81,58 | 82,17 |
| Agentic & Tool Calling | 77,57 | 79,74 |
| Instruction Following | 82,66 | 81,25 |
| Vision | 78,59 | 81,64 |
| Gesamt | 83,9 | 85,4 |
Damit liegt Bonsai 2 laut PrismML insgesamt bei ungefähr 98,2 Prozent der Ausgangsleistung.
Besonders interessant ist Mathematik: Hier liegen beide Modelle ausgesprochen dicht zusammen. Auch beim Coding ist die Differenz vergleichsweise gering. Bei Knowledge/Reasoning und Vision fällt der Abstand etwas deutlicher aus.
Für die Praxis heißt das: Bonsai 2 sollte man eher als nahe am ursprünglichen 27B-Modell bezeichnen und nicht als mathematisch identisch.
Warum ist Bonsai 2 so außergewöhnlich?
Normale Quantisierung ist längst nichts Neues. Viele lokale LLMs werden beispielsweise als Q8, Q6, Q5, Q4, Q3 oder Q2 angeboten. Dadurch sinkt der Speicherbedarf.
Normalerweise wird jedoch mit immer aggressiverer Quantisierung irgendwann ein Punkt erreicht, an dem das Modell deutlich an Qualität verliert. Insbesondere komplexes Reasoning kann unter sehr niedriger Präzision leiden.
Genau hier liegt die interessante Eigenschaft von Bonsai 2. PrismML vergleicht das Modell beispielsweise mit einer konventionellen extremen 2-Bit-Quantisierung von Qwen3.8.
Nach den veröffentlichten Tests erreicht:
- Qwen3.8-27B IQ2_XXS: 72,59
- Bonsai 2: 84,78
- Qwen3.8-27B Q4: 85,18
- Qwen3.8-27B FP16: 86,32
Bonsai liegt damit laut diesen Messungen qualitativ wesentlich näher an einer deutlich größeren Q4-Version als an einer normalen extrem kleinen 2-Bit-Quantisierung. Das ist wahrscheinlich der technisch spannendste Punkt an Bonsai 2.
27 Milliarden Parameter auf einer 8-GB-Grafikkarte?
Grundsätzlich wird das mit Bonsai 2 möglich. Die kleinste PTQ1_0-Version benötigt für die reinen Sprachmodellgewichte etwa 5,95 GB. Die schnellere PQ2_0-Version liegt bei ungefähr 7,21 GB.
Allerdings darf man Modelldateigröße und realen Speicherbedarf nicht gleichsetzen. Zusätzlich benötigt das System Speicher für unter anderem:
- KV-Cache
- Kontext
- Runtime
- CUDA beziehungsweise Metal
- temporäre Berechnungen
- Vision-Projektor
- Betriebssystem und andere Anwendungen
Eine 8-GB-GPU ist deshalb eher die untere Grenze. Auf 12 GB VRAM wird Bonsai 2 bereits erheblich interessanter. Mit 16 GB VRAM entsteht wesentlich mehr Spielraum für Kontext und zusätzliche Funktionen. Mit 24 GB, beispielsweise einer RTX 3090 oder RTX 4090, hat Bonsai 2 plötzlich ausgesprochen viel Platz für Kontext, Agenten und andere Komponenten.
Ein Beispiel: RTX 3090 mit 24 GB
Bei einem normalen vollständigen Qwen3.8 27B mit rund 55 GB Gewichten kann eine RTX 3090 das gesamte Full-Precision-Modell nicht gleichzeitig im VRAM halten. Man müsste beispielsweise CPU-Offloading verwenden, mehrere GPUs einsetzen, eine quantisierte Variante verwenden oder Teile des Modells im RAM halten.
Bonsai 2 benötigt dagegen nur einen Bruchteil dieses Speichers. Dadurch bleibt auf einer 24-GB-Karte ein großer Teil des Grafikspeichers für Kontext, Tool Calling, Vision, parallele Requests, Agentensysteme, Coding-Kontext oder andere lokale KI-Dienste verfügbar.
Genau deshalb ist der Unterschied nicht nur für schwächere Rechner interessant. Auch leistungsfähige GPUs profitieren davon.
Bonsai 2 hat weiterhin einen sehr großen Kontext
Ein weiteres bemerkenswertes Merkmal ist das Kontextfenster. PrismML nennt für Bonsai 2 262.144 Token beziehungsweise rund 262K Kontext.
Damit sind theoretisch sehr große Arbeitskontexte möglich: umfangreiche Softwareprojekte, mehrere Quellcodedateien, technische Dokumentationen, große PDFs, Dokumentensammlungen, lange Agenten-Sessions, lokale Wissenssysteme oder Repository-Analysen.
Natürlich gilt auch hier: Nur weil ein Modell 262K Token unterstützt, bedeutet das nicht, dass jeder Rechner 262K Token sinnvoll und schnell verarbeiten kann. Der Speicherbedarf des Kontextes wächst weiterhin. Die kleine Modellgröße sorgt aber dafür, dass überhaupt wesentlich mehr Speicher dafür übrig bleibt.
Qwen3.8 und Bonsai 2 können auch Bilder verstehen
Qwen3.8 27B ist multimodal. Bonsai 2 erhält diese Eigenschaft ebenfalls. Der Vision-Teil wird bei der GGUF-Version separat als sogenannter mmproj geladen. PrismML nennt dafür ungefähr 0,63 GB zusätzlich.
Damit können lokale Anwendungen beispielsweise Screenshots untersuchen, Fotos analysieren, Benutzeroberflächen verstehen, Dokumente visuell auswerten, Diagramme untersuchen oder Bilder mit einer Textfrage kombinieren. Das ist insbesondere für lokale Agentensysteme interessant.
Auch Tool Calling und lokale Agenten sind möglich
Bonsai 2 ist nicht nur als klassischer Chatbot gedacht. Das offizielle PrismML-Demo unterstützt OpenAI-kompatibles Tool Calling. Damit kann ein lokales System beispielsweise Funktionen aufrufen oder mit MCP-Servern verbunden werden.
Das eröffnet Anwendungen wie Coding Agents, lokale Desktop-Assistenten, Dateianalyse, lokale Recherche-Systeme, Entwicklungsassistenten, Automatisierungen, Smart-Home-Agenten oder interne Unternehmensassistenten. Gerade hier ist die Kombination aus relativ hoher Modellqualität und geringem Speicherbedarf interessant.
Installation von Bonsai 2 unter Windows
Für den Einstieg empfiehlt sich derzeit das offizielle Bonsai-Demo-Repository von PrismML. Das ist wichtig, weil Bonsai 2 spezielle ternäre Modellformate verwendet.
Voraussetzung
Installiert sein sollte zunächst Git. Anschließend PowerShell öffnen.
1. Repository herunterladen
git clone https://github.com/PrismML-Eng/Bonsai-demo.git
cd Bonsai-demo
2. PowerShell-Skript für diese Sitzung erlauben
Set-ExecutionPolicy -Scope Process -ExecutionPolicy BypassDamit wird nicht dauerhaft die globale Windows-Sicherheitsrichtlinie geändert, sondern lediglich die aktuelle PowerShell-Sitzung freigegeben.
3. Installation starten
.\setup.ps1Das Setup lädt die benötigte Runtime und Bonsai 2 herunter.
4. Lokalen Server starten
.\scripts\start_llama_server.ps1Anschließend kann die lokale Oberfläche im Browser geöffnet werden. Standardmäßig läuft
der Server unter http://localhost:8080.
Diese Vorgehensweise entspricht dem offiziellen Windows-Quick-Start von PrismML.
Bonsai 2 unter Linux installieren
Unter Linux ist die Installation ähnlich.
git clone https://github.com/PrismML-Eng/Bonsai-demo.git
cd Bonsai-demo
./setup.sh
Danach:
./scripts/start_llama_server.shAuch hier steht anschließend die lokale Oberfläche beziehungsweise API auf Port 8080 bereit. Alternativ lässt sich eine einzelne Anfrage direkt im Terminal stellen:
./scripts/run_llama.sh -p "Erkläre mir ternäre neuronale Netze."PrismML stellt über dasselbe Projekt Unterstützung für verschiedene Backends bereit, darunter CUDA und weitere Plattformen.
Installation auf Apple Silicon
Bonsai 2 ist auch für moderne Macs interessant, weil Apple Silicon CPU und GPU auf gemeinsamen Unified Memory zugreifen lässt. Das offizielle Repository unterstützt macOS direkt.
git clone https://github.com/PrismML-Eng/Bonsai-demo.git
cd Bonsai-demo
./setup.sh
./scripts/start_llama_server.sh
Bonsai 2 ist außerdem als spezielle MLX-2-Bit-Version verfügbar. PrismML stellt hierfür ein eigenes Modell bereit. Für MacBooks mit ausreichend Unified Memory ist das besonders interessant, da kein klassischer VRAM/RAM-Split wie bei einem PC mit separater NVIDIA-GPU existiert.
Welche Bonsai-Version sollte man verwenden?
Es gibt derzeit zwei besonders relevante GGUF-Packings.
PTQ1_0
Ungefähr 5,95 GB beziehungsweise etwa 1,75 Bit pro Gewicht. Der Fokus liegt auf minimalem Speicherbedarf.
PQ2_0
Ungefähr 7,21 GB beziehungsweise etwa 2,13 Bit pro Gewicht. Diese Variante benötigt etwas mehr Speicher, ermöglicht dafür schnelleres Prompt Processing.
Das offizielle Bonsai-Demo verwendet derzeit PQ2_0 als Standard. Für Geräte mit sehr knappem Speicher kann PTQ1_0 sinnvoll sein. Auf einer 12-, 16- oder 24-GB-GPU würde ich dagegen zuerst PQ2_0 ausprobieren.
Installation des originalen Qwen3.8 27B ohne Bonsai
Wer das unveränderte Ausgangsmodell verwenden möchte, kann Qwen3.8 27B direkt über Hugging
Face und Transformers laden. Das offizielle Modell lautet Qwen/Qwen3.8-27B.
Qwen zeigt beispielsweise folgenden Python-Weg:
from transformers import AutoProcessor, AutoModelForMultimodalLM

processor = AutoProcessor.from_pretrained(
    "Qwen/Qwen3.8-27B"
)

model = AutoModelForMultimodalLM.from_pretrained(
    "Qwen/Qwen3.8-27B",
    device_map="auto"
)
Die offizielle Modellseite stellt zusätzlich Beispiele für vLLM und SGLang bereit. Für einen lokalen OpenAI-kompatiblen vLLM-Server beispielsweise:
pip install vllm
vllm serve "Qwen/Qwen3.8-27B"
Das vollständige Hugging-Face-Repository umfasst momentan etwa 55,6 GB. Für die vollständige Variante sollte deshalb deutlich mehr Systemspeicher als lediglich die Modelldateigröße eingeplant werden.
Warum nicht einfach Qwen3.8 Q4 verwenden?
Das ist eine berechtigte Frage. Eine gute Q4-Quantisierung von Qwen3.8 27B ist ebenfalls deutlich kleiner als FP16 und qualitativ normalerweise sehr stark.
PrismML nennt für eine getestete Q4-Variante ungefähr 17,56 GB gegenüber 5,95 GB für Bonsai 2. Die Benchmarkwerte lagen dabei laut PrismML bei:
- Qwen Q4: 85,18
- Bonsai 2: 84,78
- Qwen FP16: 86,32
Damit benötigt Bonsai ungefähr ein Drittel des Speicherplatzes der dort verglichenen Q4-Variante, während der gemessene Leistungsabstand gering bleibt.
Für eine 24-GB-GPU ist Q4 weiterhin eine hervorragende Option. Für 8-, 12- oder 16-GB-Hardware verändert Bonsai aber die Ausgangslage erheblich.
Warum Bonsai für lokale KI wichtiger sein könnte als ein weiterer Benchmark-Rekord
Bei lokalen Modellen konzentriert sich die Diskussion häufig darauf, welches Modell ein paar Punkte mehr in einem Benchmark erreicht. In der Realität gibt es aber eine zweite entscheidende Größe:
Kann ich das Modell überhaupt sinnvoll auf meiner Hardware betreiben?
Ein extrem intelligentes 55-GB-Modell hilft einem Nutzer mit 12 GB VRAM wenig, wenn große Teile ständig zwischen RAM und GPU verschoben werden müssen. Ein Modell mit fast derselben praktischen Leistungsfähigkeit, das vollständig in den Grafikspeicher passt, kann real erheblich angenehmer und teilweise schneller sein.
Das ist die eigentliche Bedeutung von Bonsai 2. Es geht weniger darum, Qwen zu ersetzen. Es geht darum, Qwen3.8-27B-Klasse auf Hardware verfügbar zu machen, auf der ein vollständiges 27B-Modell zuvor kaum praktikabel war.
Geschwindigkeit: Klein bedeutet nicht automatisch neunmal schneller
Auch hier sollte man vorsichtig sein. Wenn ein Modell neunmal kleiner gespeichert wird, folgt daraus nicht, dass es neunmal schneller antwortet.
Die tatsächliche Geschwindigkeit hängt unter anderem ab von GPU, Speicherbandbreite, Runtime, verwendeter Bonsai-Version, Kontextlänge, Promptgröße, CPU-Offloading, Betriebssystem und Batchgröße.
Die ersten Community-Benchmarks im offiziellen PrismML-Repository zeigen beispielsweise für Bonsai 2 PQ2_0 auf einer RTX 4090 ungefähr 84,9 generierte Token pro Sekunde im dort verwendeten TG128-Test. Für PTQ1_0 wurden etwa 86 Token/s gemeldet. Diese Community-Messungen sind jedoch keine kontrollierten Vergleichswerte zwischen unterschiedlichen Rechnern.
Auf einer AMD RX 7800 XT wurden dort beispielsweise 46,8 Token/s gemeldet.
Das zeigt: Bonsai 2 kann durchaus sehr schnell laufen. Die konkrete Leistung sollte aber immer auf der eigenen Hardware gemessen werden.
Der wahrscheinlich größere Vorteil: mehr freier Speicher
Die Geschwindigkeit ist nur ein Teil der Geschichte. Stellen wir uns zwei Installationen auf einer GPU mit 24 GB VRAM vor. Eine Q4-Version von Qwen benötigt vielleicht rund 17 GB für die Modellgewichte. Bonsai benötigt ungefähr 6 bis 7 GB. Damit entstehen grob zehn Gigabyte zusätzlicher Spielraum.
Dieser Speicher kann für etwas sehr Wertvolles genutzt werden: Kontext.
Gerade bei Coding-Agents oder großen Dokumentanalysen kann dieser Unterschied wichtiger werden als ein paar Prozent Benchmarkleistung.
Datenschutz: Warum lokale Modelle interessant sind
Ein lokal ausgeführtes Modell kann vollständig auf dem eigenen Rechner betrieben werden. Dadurch müssen Prompts, Quellcode und Dokumente nicht zwangsläufig an einen externen KI-Provider übertragen werden.
Das kann insbesondere interessant sein für Entwickler, Unternehmen, interne Dokumente, vertraulichen Quellcode, Forschungsdaten, Offline-Systeme oder lokale Assistenten.
Natürlich hängt der tatsächliche Datenschutz der gesamten Lösung zusätzlich von der verwendeten Benutzeroberfläche, Erweiterungen, Tools und verbundenen Diensten ab. „Lokales Modell“ bedeutet nicht automatisch, dass jede damit verbundene Software offline arbeitet.
Bonsai 2 oder Qwen3.8 27B – was sollte man verwenden?
Es gibt keinen pauschalen Gewinner.
Das originale Qwen3.8 27B ist sinnvoll, wenn …
maximale Modelltreue wichtiger ist als Ressourcenverbrauch. Wer über sehr viel VRAM oder Unified Memory verfügt und die vollständige Präzision benötigt, hat keinen zwingenden Grund, diese Information wegzukomprimieren. Insbesondere für reproduzierbare Forschung oder Vergleiche ist das Originalmodell die sauberere Referenz.
Qwen3.8 Q4 ist interessant, wenn …
genug VRAM vorhanden ist und ein klassisches, sehr gut unterstütztes Quantisierungsformat bevorzugt wird. Auf einer 24-GB-GPU ist eine hochwertige Q4-Version weiterhin attraktiv.
Bonsai 2 ist besonders interessant, wenn …
ein möglichst leistungsfähiges 27B-Modell auf begrenzter lokaler Hardware laufen soll. Das betrifft insbesondere 8-GB-GPUs, 12-GB-GPUs, 16-GB-GPUs, Laptops, Apple-Silicon-Systeme, lokale Coding-Agenten und Systeme mit großem Kontextbedarf.
Auch auf einer RTX 3090 oder 4090 kann Bonsai sinnvoll sein, weil der eingesparte Speicher für andere Aufgaben zur Verfügung steht.
Ist Bonsai 2 also „das gleiche Modell für ein Zehntel des Speichers“?
Als Kurzbeschreibung ist das verständlich. Technisch würde ich es allerdings anders formulieren:
Bonsai 2 bringt die Qwen3.8-27B-Modellklasse mit extrem komprimierten ternären Gewichten auf lokale Hardware und erreicht in PrismMLs Tests rund 98,2 Prozent der aggregierten FP16-Benchmarkleistung bei ungefähr einem Neuntel des Modell-Footprints.
Das ist präziser. Denn die Aussage „100 Prozent identisch“ würde der Technik nicht gerecht. Und Bonsai braucht diese Übertreibung gar nicht. Ein 27B-Modell von ungefähr 55 GB auf etwa 6 GB zu reduzieren und dabei laut Hersteller nur rund zwei Prozent aggregierte Benchmarkleistung einzubüßen, ist bereits bemerkenswert genug.
Was bedeutet das für lokale KI?
Bonsai 2 zeigt eine Entwicklung, die für lokale KI möglicherweise wichtiger wird als immer größere Modelle. Nicht nur: Wie viele Parameter können wir trainieren? Sondern: Wie viel brauchbare Intelligenz bekommen wir pro Gigabyte Speicher?
Bislang bedeutete ein leistungsfähigeres lokales Modell fast automatisch: mehr VRAM, mehr RAM, größere GPUs und höhere Hardwarekosten. Ternäre Modelle könnten diese Gleichung verändern.
Sollte sich der Ansatz auch bei zukünftigen und noch größeren Modellen bewähren, könnten leistungsfähige KI-Agenten zunehmend auf normalen Endgeräten laufen. Ein 27B-Modell auf einer Grafikkarte mit 8 oder 12 GB wäre dann nicht länger die Ausnahme. Sondern möglicherweise der Anfang einer neuen Generation lokaler KI.
| Merkmal | Qwen3.8 27B FP16 | Qwen3.8 27B Q4 | Bonsai 2 PTQ1_0 | Bonsai 2 PQ2_0 |
|---|---|---|---|---|
| Modellgröße | ca. 55–57 GBHersteller | ca. 17,56 GBHersteller | ca. 5,95 GBHersteller | ca. 7,21 GBHersteller |
| Bit pro Gewicht | 16 | ca. 4 | ca. 1,75Hersteller | ca. 2,13Hersteller |
| Benchmark gesamt | 86,32Hersteller | 85,18Hersteller | 84,78Hersteller | — |
| Kontextfenster | — | — | 262.144 TokenHersteller | 262.144 TokenHersteller |
| Vision | ja | ja | ja (mmproj ca. 0,63 GB) | ja (mmproj ca. 0,63 GB) |
| Tool Calling | ja | ja | ja (OpenAI-kompatibel im Demo) | ja (OpenAI-kompatibel im Demo) |
| Praktisch ab | Multi-GPU / sehr viel Unified Memoryunbestätigt | 24 GB VRAMunbestätigt | 8 GB VRAM (Untergrenze)Schätzung | 12 GB VRAMSchätzung |
Fazit
Bonsai 2 macht aus Qwen3.8 27B kein kleineres Sprachmodell. Es komprimiert die Gewichte desselben 27B-Ausgangspunktes drastisch.
Das vollständige Qwen3.8-27B-Repository liegt derzeit bei ungefähr 55,6 GB. Bonsai 2 reduziert das eigentliche Sprachmodell je nach Packing auf ungefähr 5,95 bis 7,21 GB. Laut PrismML bleiben dabei rund 98,2 Prozent der aggregierten Benchmarkleistung erhalten.
Damit wird Qwen3.8-27B-Klasse plötzlich für Rechner interessant, auf denen die Full-Precision-Version praktisch nicht sinnvoll ausführbar wäre. Besonders für lokale Coding-Agenten, private KI-Systeme und Rechner mit 8 bis 24 GB VRAM dürfte Bonsai 2 deshalb eines der derzeit interessantesten Experimente im Bereich effizienter lokaler LLMs sein.
Entscheidend wird nun sein, wie sich das Modell außerhalb der Herstellerbenchmarks im langfristigen Praxiseinsatz schlägt. Denn wenn sich der Ansatz bestätigt, könnte die vielleicht spannendste Eigenschaft zukünftiger lokaler KI-Modelle nicht ihre Parameterzahl sein. Sondern wie wenig Hardware sie benötigen.
Häufige Fragen
Ist Bonsai 2 dasselbe Modell wie Qwen3.8 27B?
Von der Abstammung her ja — Bonsai 2 basiert direkt auf Qwen3.8 27B. Numerisch nicht: Die Kompression verändert die ursprünglichen Gewichtswerte. Laut PrismML bleiben rund 98,2 Prozent der aggregierten Benchmarkleistung erhalten.
Läuft Bonsai 2 auf einer Grafikkarte mit 8 GB?
Die Modellgewichte der PTQ1_0-Fassung belegen etwa 5,95 GB. Dazu kommen KV-Cache, Kontext, Runtime und der Vision-Projektor. 8 GB sind deshalb die untere Grenze; ab 12 GB wird es im Alltag angenehm.
Welche Fassung soll ich nehmen, PTQ1_0 oder PQ2_0?
PTQ1_0 bei sehr knappem Speicher, sonst PQ2_0 — die Standardwahl des offiziellen Demos, mit schnellerem Prompt Processing bei rund 7,21 GB.
Sind die 98,2 Prozent unabhängig bestätigt?
Nein. Die Zahl stammt aus PrismMLs eigener Messung. Unabhängige Tests über verschiedene Hardware hinweg gab es zum Stand dieses Artikels deutlich weniger als für etablierte Qwen-Quantisierungen.
Brauche ich eine besondere Runtime?
Ja. Für die empfohlenen GGUF-Fassungen ist die von PrismML bereitgestellte Runtime beziehungsweise deren angepasste llama.cpp-Binaries vorgesehen. PrismML warnt davor, die Dateien mit einer ungeeigneten Standard-Runtime zu laden.
Quellen
- PrismML – Introducing Bonsai 2 27B: Near-Lossless Compression in a 9x Smaller FootprintHerstellerquelleAngaben zur Qwen3.8-27B-Basis, ternäre Gewichte, 1,76 Bit pro Gewicht, 5,9 GB Modellgröße, 262K Kontext, Benchmark-Retention 98,2 Prozent. [sig:d699e81cb2bfc95f]
- PrismML – Bonsai 2 27B: offizielle ProduktankündigungHerstellerquelleBeschreibung des Modells für Reasoning, Coding, Vision und agentische Anwendungen. [sig:3e56cf463b9dac2a]
- Installationsanleitungen, CUDA/Vulkan/ROCm/Metal, Vision, Tool Calling, Formate PTQ1_0 und PQ2_0. [sig:24fec726ba58a34e]
- PrismML – Bonsai Demo README / InstallationDokumentationWindows-PowerShell-Installation, Linux/macOS-Setup, Startbefehle des lokalen llama.cpp-Servers. [sig:bbeb5455bb903608]
- Modelldateien, Lizenz, Hinweise zur lokalen Nutzung mit llama.cpp. [sig:10c53f66d3cac740]
- PrismML – Ternary Bonsai 2 27B GGUF: DateienHugging FaceÜbersicht der veröffentlichten Modelldateien. [sig:3c8f692aa26b9ad2]
- Qwen – Qwen3.8 27B auf Hugging FaceHugging FaceOffizielles Ausgangsmodell: Beschreibung, Lizenz, Architektur, Nutzung. [sig:4d9a45b509a91485]
- Qwen – Qwen3.8 27B ModelldateienHugging FaceDateiansicht als Referenz für die 55,6 GB des vollständigen Repositories. [sig:30294503feda3eee]
- Erste Messungen auf RTX 4090 (ca. 84,9 bzw. 86 Token/s) und RX 7800 XT (46,8 Token/s). Keine kontrollierten Vergleichswerte. [sig:24fec726ba58a34e]
Lokale KI im eigenen Betrieb?
Wir planen, bauen und betreiben KI-Systeme, die im Haus bleiben — vom Einzelrechner bis zur Serverlösung. Erste Einschätzung kostenlos.
Projekt besprechen →